Quase dois terços dos países da Região Europeia da Organização Mundial da Saúde já usam inteligência artificial em diagnósticos. Apenas 8% têm uma estratégia específica para IA na saúde. A mesma proporção definiu padrões de responsabilidade para os casos em que um sistema falha.
Os números, apresentados pela OMS em julho de 2026, expõem uma inversão incômoda: a tecnologia entrou na rotina antes que muitas instituições respondessem quem decide, quem verifica e quem assume as consequências. Metade dos países avaliados já introduziu chatbots para pacientes, mas só um em cada cinco oferece formação sobre IA aos profissionais antes da qualificação.
O problema não começa na tela em que aparece uma recomendação. Começa muito antes, nos registros clínicos, nas definições usadas por cada setor, nos campos que ficaram vazios, na forma como os dados foram anonimizados e nas regras que determinam quando uma pessoa pode contrariar a máquina. Sem essa base, um modelo sofisticado pode apenas processar desorganização com mais velocidade.
Antes do algoritmo, existe um trabalho invisível
Um artigo revisado por pares, publicado em 27 de julho de 2026 no Computational and Structural Biotechnology Journal, oferece uma visão concreta desse trabalho. A equipe partiu de 39 meses de registros sobre infecções associadas à assistência à saúde em um hospital distrital chinês com 1.100 leitos.
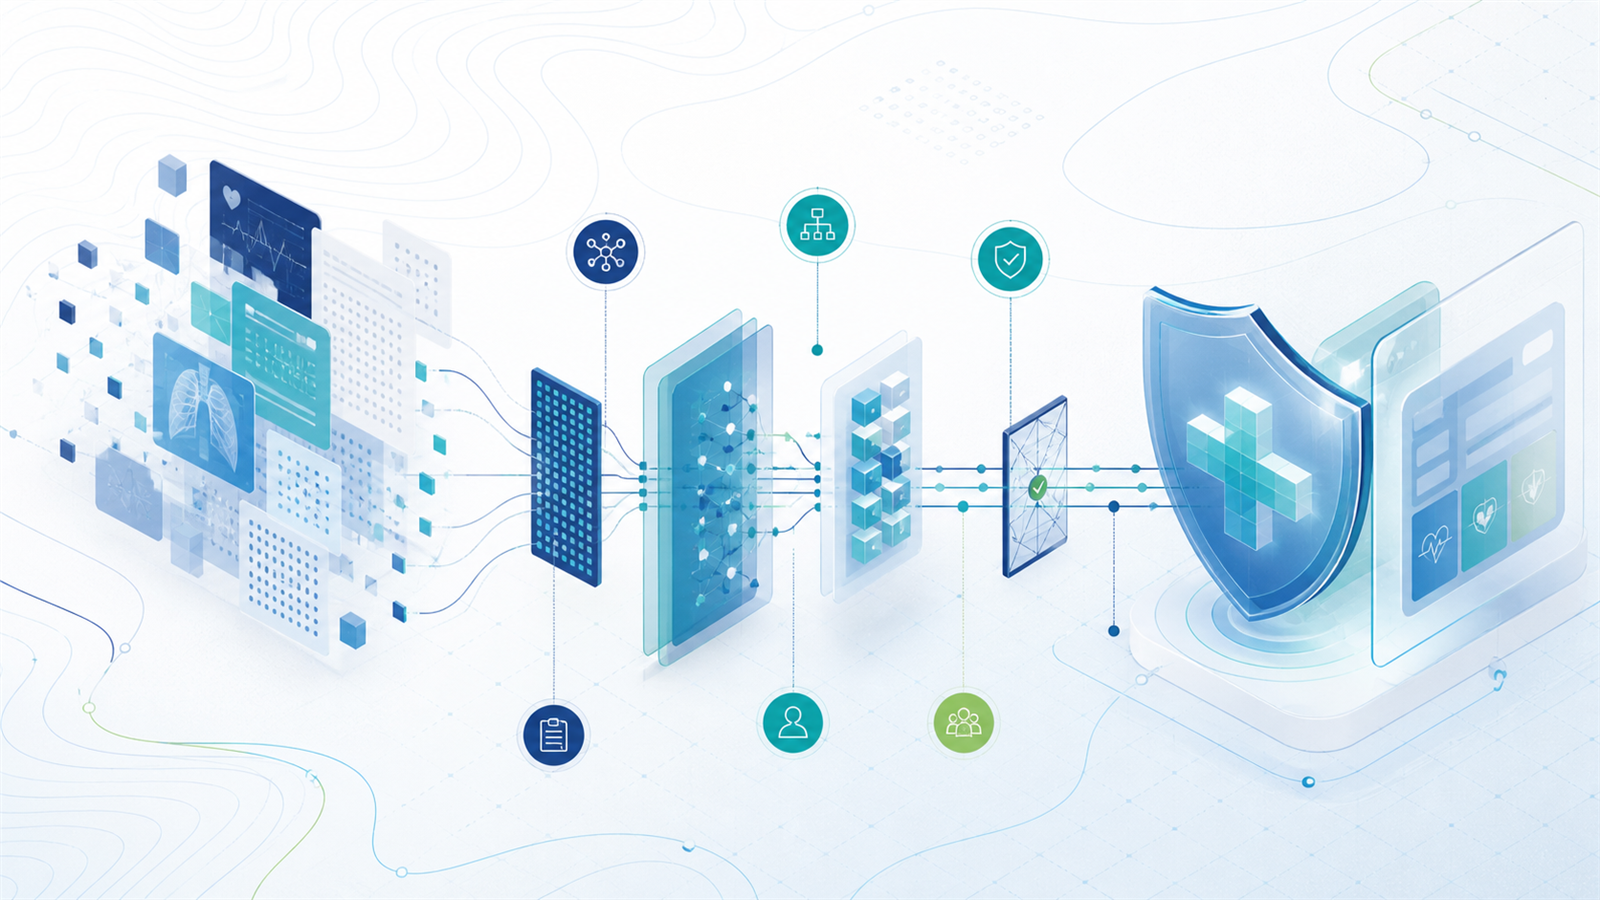
Não havia uma planilha estável pronta para treinar modelos. Os pesquisadores encontraram 39 arquivos mensais, 14 variações de estrutura, cabeçalhos que mudavam com o tempo, termos clínicos em texto livre, fatores de risco reunidos em um único campo e períodos sem denominadores completos. Antes de testar qualquer algoritmo, foi preciso construir uma cadeia de seis etapas para detectar, harmonizar, normalizar, decompor, traduzir e desidentificar os registros.
Esse detalhe muda a leitura do estudo. A principal entrega não é um sistema que promete prever o futuro de pacientes. É um conjunto de dados rastreável, acompanhado de código, dicionário de variáveis e regras de transformação que permitem entender de onde cada informação veio.
O que significa tornar um dado “pronto para IA”
A expressão pode sugerir apenas uma tabela limpa. No artigo, ela exige mais. O conjunto final reúne 1.240 episódios de infecção, 57 variáveis e um dicionário com 115 entradas. Os dados e o código foram depositados em um repositório público, com licença, histórico de procedência e instruções de reprodução.
Os autores trabalharam com os princípios FAIR: dados localizáveis, acessíveis sob regras claras, interoperáveis e reutilizáveis. Isso não significa divulgar prontuários. Nomes, números de registro, profissionais e leitos foram removidos. Datas foram reduzidas à precisão de ano e mês na versão pública, e combinações de atributos foram avaliadas para diminuir o risco de reidentificação.
Também houve uma escolha importante de engenharia: o processo foi desenhado para interromper quando encontrasse um cabeçalho ou termo desconhecido, em vez de descartar silenciosamente o que não reconhecia. Em sistemas de saúde, uma falha visível pode ser mais segura do que uma planilha aparentemente completa que perdeu informações no caminho.
Dois exemplos mostram por que a revisão humana continuou necessária. Para separar fatores de risco escritos em texto livre, dois profissionais anotaram uma amostra e compararam o resultado com a extração automática. Na tradução dos termos clínicos, a equipe avaliou as 156 categorias do dicionário e corrigiu duas equivalências raras. A automação fez o trabalho repetitivo; especialistas verificaram se o significado clínico havia sido preservado.
O modelo funcionou? Essa não é a pergunta principal
Como demonstração, os pesquisadores usaram três modelos de aprendizado de máquina para prever marcadores de resistência antimicrobiana entre 604 episódios com cultura positiva. O melhor resultado foi uma área sob a curva ROC de 0,82, com intervalo de confiança de 0,74 a 0,89.
Esse indicador mede a capacidade de ordenar casos positivos e negativos ao longo de diferentes limiares. Não prova que o modelo esteja pronto para decidir tratamento, substituir avaliação clínica ou funcionar em outro hospital. O teste usou uma divisão interna dos dados de uma única instituição e uma amostra relativamente pequena. Não houve validação externa entre hospitais.
Os próprios autores registram limites adicionais: condições associadas estavam em texto livre, alguns fatores podem não ter sido anotados na origem e faltavam denominadores de pacientes-dia para parte do período. A interoperabilidade semântica também ficou incompleta, porque nem todos os termos foram convertidos integralmente para padrões como SNOMED CT ou ICD-10-CM.
O artigo é relevante justamente por não esconder essas bordas. Publicado como pesquisa revisada por pares, com DOI persistente, aprovação ética e dados desidentificados, ele informa financiamento público regional e declara ausência de conflitos de interesse. Ainda assim, seus resultados são um ponto de partida metodológico, não uma autorização para uso clínico.
A distância entre demonstrar e colocar em serviço
A OMS chama atenção para essa passagem. Uma prova de conceito responde se há sinal nos dados. Uma implantação real precisa responder se o sistema é seguro no ambiente em que será usado, se os profissionais entendem suas limitações, se existe monitoramento de desempenho e se alguém pode interrompê-lo quando o contexto muda.
Há aplicações promissoras. Em Coimbra, Portugal, análise de imagens apoiada por IA tem ajudado equipes a identificar doenças torácicas e fraturas com mais rapidez, segundo a OMS. O exemplo mostra benefício possível em situações concretas. Não elimina a necessidade de verificar qualidade dos dados, diferenças entre populações, taxa de erro e impacto sobre quem não aparece bem representado nos registros.
O risco não é apenas uma previsão errada. Um sistema pode privilegiar o que é fácil medir e deixar de lado experiência profissional, conhecimento comunitário e condições sociais. Pode otimizar o tempo de atendimento e piorar a equidade. Pode produzir uma recomendação correta sem deixar claro quais dados utilizou. Pode continuar operando depois que mudanças no serviço tornaram seu treinamento antigo.
Por isso, um documento de discussão publicado pela OMS em junho recomenda avaliações de impacto algorítmico e de prontidão tecnológica antes da implantação. Depois da entrada em uso, propõe evidências atualizadas, verificação humana, pontos explícitos de decisão e supervisão multidisciplinar. Governança, nesse contexto, não é uma etapa burocrática posterior: é parte do funcionamento do sistema.
Cinco perguntas que antecedem uma compra ou parceria
Para governos, hospitais, universidades e organizações que avaliam soluções de IA na saúde, a qualidade da decisão melhora quando a conversa começa pelo problema e não pela ferramenta:
- Qual decisão será apoiada? É preciso definir quem recebe a recomendação, em que momento e o que acontece quando ela estiver errada.
- Os dados representam o público atendido? Procedência, períodos, ausências, mudanças de padrão e grupos pouco representados precisam estar documentados.
- O desempenho foi validado fora do ambiente de desenvolvimento? Um resultado interno não garante funcionamento em outra instituição, equipamento ou população.
- Quem pode revisar, contestar e interromper? A supervisão humana precisa ter autoridade real, não apenas confirmar automaticamente o sistema.
- Como o desempenho será acompanhado? Erros, mudanças de contexto, incidentes, segurança e efeitos distributivos exigem monitoramento contínuo.
Essas perguntas valem também para iniciativas de menor escala. Um piloto em uma universidade ou serviço regional não precisa reproduzir a estrutura de um sistema nacional, mas deve preservar finalidade clara, minimização de dados, base legal, rastreabilidade, segurança e revisão por pessoas qualificadas.
O que essa discussão entrega ao leitor
O estudo chinês não descreve Diamantina nem autoriza extrapolações para a realidade local. Sua utilidade é outra: tornar visível a infraestrutura de confiança que qualquer projeto sério terá de construir. O fato de uma instituição possuir muitos registros não significa que tenha dados adequados para IA. O fato de um modelo atingir bom desempenho não significa que esteja pronto para orientar cuidado.
A diferença entre uma demonstração e um serviço responsável está no percurso: documentar a origem, reconhecer o que falta, proteger pessoas, testar em contexto, formar equipes e manter uma porta aberta para revisão.
A IA já participa de diagnósticos, políticas públicas e conversas de pacientes. A governança não pode continuar correndo atrás. Antes de perguntar qual algoritmo usar, instituições precisam decidir que evidência aceitam, quais riscos não estão dispostas a transferir e quem terá poder para dizer não.
Informações conferidas em 10 de agosto de 2026. O artigo científico está na versão de registro publicada em 27 de julho de 2026.
Fontes
- HAN, D.; SHU, X.; HU, Y. et al. From Raw Hospital Records to an AI-Ready Surveillance Dataset. Computational and Structural Biotechnology Journal, 2026. DOI: 10.34133/csbj.0185.
- Zenodo — conjunto de dados, código e documentação do estudo. DOI: 10.5281/zenodo.20725167.
- OMS Europa — adoção e governança de IA na saúde, 15 de julho de 2026.
- OMS — IA e políticas de saúde orientadas por evidências, 2 de junho de 2026.